TF-IDFに潜む統計的なものの見方
32歳でデータサイエンティストに転身したとき、自分が配属されたのはテキストマイニングのチームだった。
LLM全盛の今日において、もはやテキストマイニングという言葉を見聞きすることはほとんどない。しかし、データ分析者として第一歩を踏み出すにあたって、テキスト分析やNLP(自然言語処理)を学べたのはよかったと思っている。
当然ながらLLMもDNNもない時代、それどころか機械学習のパイプラインも整備されていない放牧的な世界でのマイニングは、様々な道具や視点を経験させてくれた。特に、計量することが難しい「言葉」を定量的に捉えるという仕事は、統計的なものの見方を柔らかく学ぶのに適していた。また、確たる理論がなく工学的な手触り感の中で、分析者として謙虚になることを学べたのも大きいと思っている。
テキストマイニングにおいて絶対的で権威的な意味を引き出すことはできない。それはどこまでも手持ちのデータにおける相対的な傾向にすぎない。それゆえ、テキストマイニングに携わる分析者は、技術と分析対象ドメインの両方に謙虚でなくてはならないのだ。
さて、そんなテキストマイニングの仕事の中で出合ったのが「TF-IDF」という単語の計量方法だ。文書集合が与えられたとき、その中に存在するある単語の重要度を数値化する手法の一つ。次のような式を使って簡単に計算することができる。
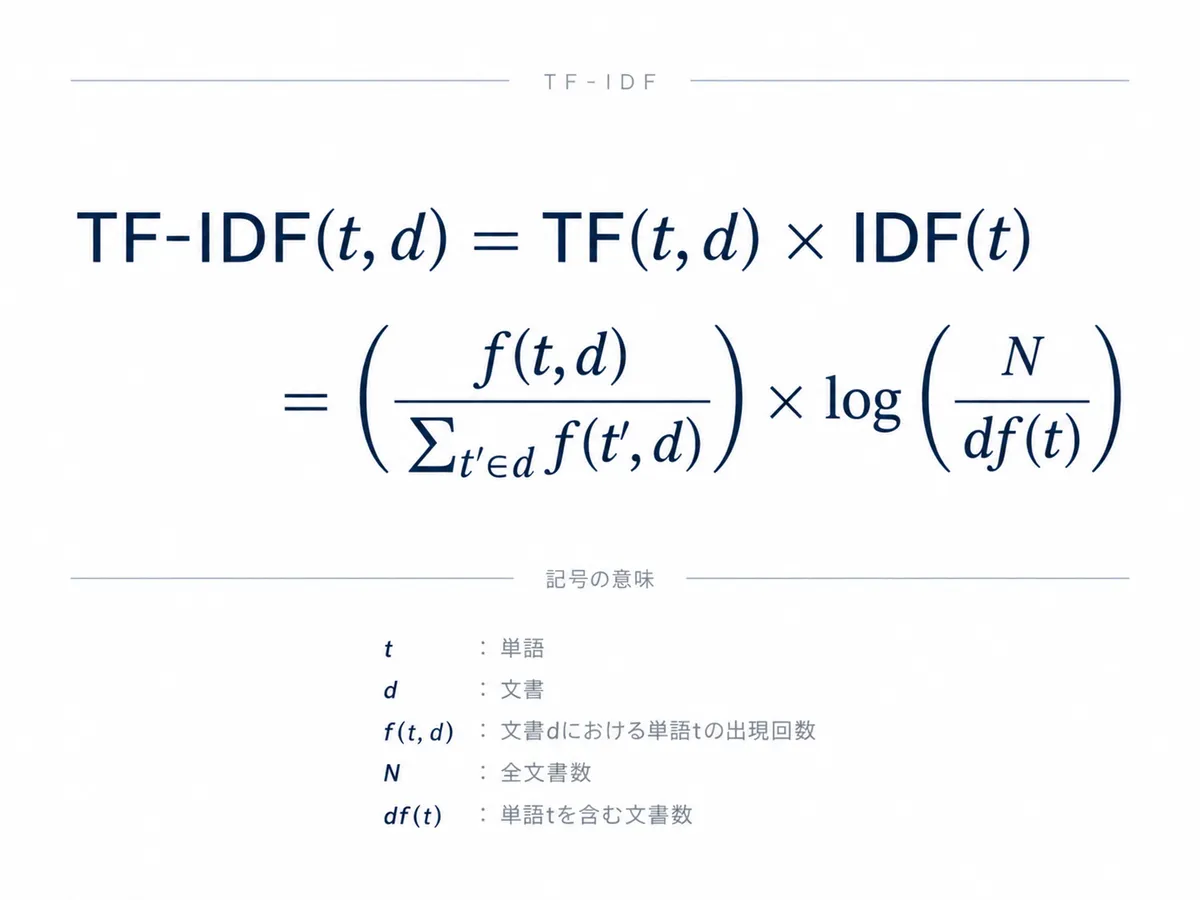
例えば、目の前に様々なニュースについて述べたブログ記事が10,000個あるとする。テキストデータだけで、その各々の記事の特徴をつかむにはどうしたらいいだろう。時間に余裕があるのなら、一つ一つの記事を人が読んで判断すればよいかもしれないが、たいていそんな時間はない。それに、特徴とは何をもって特徴とすればいいか迷ってしまう。
ここで、ニュースや世の中の情報に対する前提知識が一切なく、ニュースに含まれる単語の情報からそれの特徴を捉えるにはどうしたらよいだろうか。この問いに対し、各文書に頻出する単語の違いから特徴付けられるのではないか、というのがテキストマイニングの基本的なやり口だ。
しかし、単純に文書中に含まれる単語の出現回数(先の式でいうTF)を取ると、たいてい妙なことになってしまう。おそらく多くの文書で「です」「ます」「本日」などの、日本語文書によく出てくる単語や形態素が上位を占めることになるからだ。これではその文書の特徴を表すことにならない。
そこで、どの文書でも出現するような単語は、その重要度を下げればよいというのがTF-IDFの考え方だ。先の式でいうIDFがこれを実現するカラクリであり、その単語が出現する文書が多いほどスコアが下がる仕組みになっている。
シンプルだけどとても理にかなったアルゴリズムで、今も使われることが多い。TF-IDFを改良した手法がいくつも提案されているものの、なかなか超えられないという話も聞く。
さて、このTF-IDFの考え方には、テキストマイニングのエッセンスがギュッと凝縮していると思う。具体的には、以下のようなものだ。
- データを特徴付けるためにその中に含まれる単語を計量する。
- 単語の意味が分からなくとも、その出現分布の違いからデータの傾向を分析していく。
- 分析対象とする単語群は、手持ちのデータの範囲の中で相対的に比較されて特徴付けされる。
逆に言えば、テキストマイニングで得られる知見というのは、手元にあるデータ集合の中で言えることにすぎない。ゆえに、データ母集団が変わればそこに含まれる単語が変わってくるし、データ量が増えただけでも単語数が増えるかもしれない。つまり、TF-IDFではじき出した特徴というのは、データが変わるたびに変わる可能性がある。
こうした背景があるため、統計的に言えば、こうしたテキストマイニングは記述レベルの分析ということになる。標本を注意深く抽出したり、統計モデルや機械学習モデルを考慮してはじめてそのインサイトに少しの汎用性が生まれる。
そうした工夫により予測レベルの分析まではできるかもしれないが、因果推論はより難しくなるだろう。仮に単語の抽出を緻密に固定できたとしても、その生成過程は不明瞭であり、結果的に交絡を見落としてしまう可能性があるからだ。
そのため、テキストマイニグや統計的自然言語処理を使ってデータを分析するアナリストは、分析アプローチや結果について謙虚にならざるを得ない。自分が発見したインサイトが、絶対的でユニバーサルなものだとは口が裂けても言えないだろう。
したがって、手元のデータに含まれる単語を手掛かりに相対的な傾向を捉えた、というスタンスを持つべきだ。これは、テキストマイニングチームのボスや同僚から叩き込まれたことで、報告書の文言だけでなく話し言葉まで厳しく指導されたものだ。
さて、長々と古典的なTF-IDFを元にテキストマイニングの話をしてきた。LLM全盛の時代にあって、ここで書いたことは化石のように感じるかもしれない。実際にそのノウハウの多くは使われないだろう。
しかし、以下の部分に再度着目してみると、多くのデータ分析の場面でヒヤッとするはずだ。
手元のデータに含まれる単語を手掛かりに相対的な傾向を捉えた
ここで「単語」を「特徴量」と読み替えてみると、実に多くのデータ分析仕事に通じる命題であることが分かる。
手元のデータに含まれる特徴量を手掛かりに相対的な傾向を捉えた
例えば、直近のエンゲージメントサーベイの結果を可視化した結果、特定の部署や年代のスコアが低いことが分かったとする。それは組織の問題を捉える重要な一歩目であるが、だからといってそれがその会社の普遍的で絶対的なファクトを示すものではない。あくまで相対的な傾向だ。
あるいは、同サーベイに含まれる設問を丁寧に分解し、因子分析や複雑な統計モデルで因子同士の関係を明らかにしたとしよう。先ほどよりも難しい手法を用いているが、スナップショットなデータを使って分析をしている限り、それが普遍的な知見であるとは主張しにくい。
このように、データから得られる知見の多くは相対的で記述的なものだ。そこに予測に適したモデリングアプローチを投入すれば予測ができるし、因果推論のためのデザインやケアを行えば、因果関係を探ることができるかもしれない。
ただし、記述、予測、因果推論の間の溝は相当に深く、簡単に乗り越えられるわけではない。そのため、データアナリストやデータサイエンティストは、経験を積めば積むほど謙虚になる傾向にある。
それでもなお、TF-IDFのような相対的に計量するというアイデアは、多くの分析シーンで有用でもある。かつて、TF-IDFのアルゴリズムを転用して、見積伝票の誤りを見つけることに成功したこともあるし、組織内の異動経験を特徴付けすることもできた。手掛かりとなるデータが少ない分野こそ、こういった手法が活きる。
このように、TF-IDFの考え方はシンプルだが、データ分析という仕事の難しさや考え方、発想を学ぶ上で有益だ。「何と比べて特徴的なのか」「その結果はどこまで言えることなのか」を考える視点を与えてくれるからだ。
そして、この知見はAIに分析を任せる状況においても常に頭に入れておく必要があるだろう。